Seedance — модель совместной генерации звука и видео от ByteDance Seed. Версия 2.5 выдаёт до 30 секунд за одну генерацию и продлевает ролик дважды.
Seedance
Преимущества Seedance 2.5
Длиннее и управляемее
До 30 секунд в одной генерации, и ролик можно продлить дважды — этого хватает на законченную сцену. Движение стало плавнее и держится ровнее, картинка ближе к съёмочной.
Понимает референс
Модель считывает с референсного видео замысел, кадрирование и киноязык, то есть идёт дальше переноса движения и трактует материал. Правка стала надёжнее и отзывается на более широкий круг запросов: и по звуку, и по картинке.
Рассчитана на продакшен
Управление по белой модели и правка на хромакее, профессиональная работа камеры и разводка актёров в кадре настроены под сложное производство, а не под ролик в ленту.
Результат
Тридцать секунд — это законченная сцена. С двумя продлениями выходит эпизод, который не приходится склеивать из кусков и вычищать на стыках прыжки света и лиц.
Три поколения Seedance
| Версия | Длина | Звук | Референс |
|---|---|---|---|
| Seedance 2.5 текущее поколение |
до 30 секунд за генерацию, продление дважды | звук и видео одной генерацией | считывает замысел, кадрирование и киноязык референса |
| Seedance 2.0 предыдущее поколение |
короче, продления нет | отдельным шагом | перенос движения с референса |
| Seedance 1.5 первая линейка, включая 1.5 Pro |
короткие ролики | нет | нет |
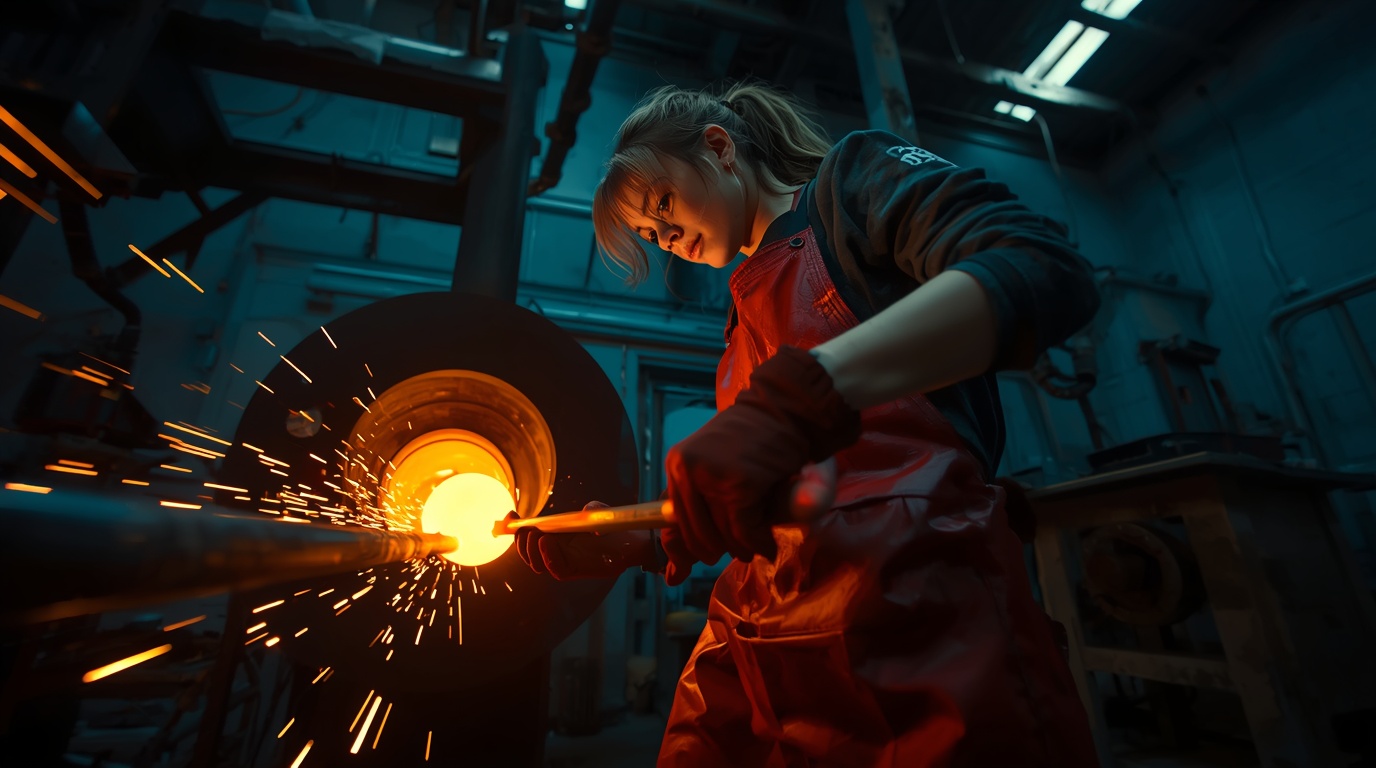
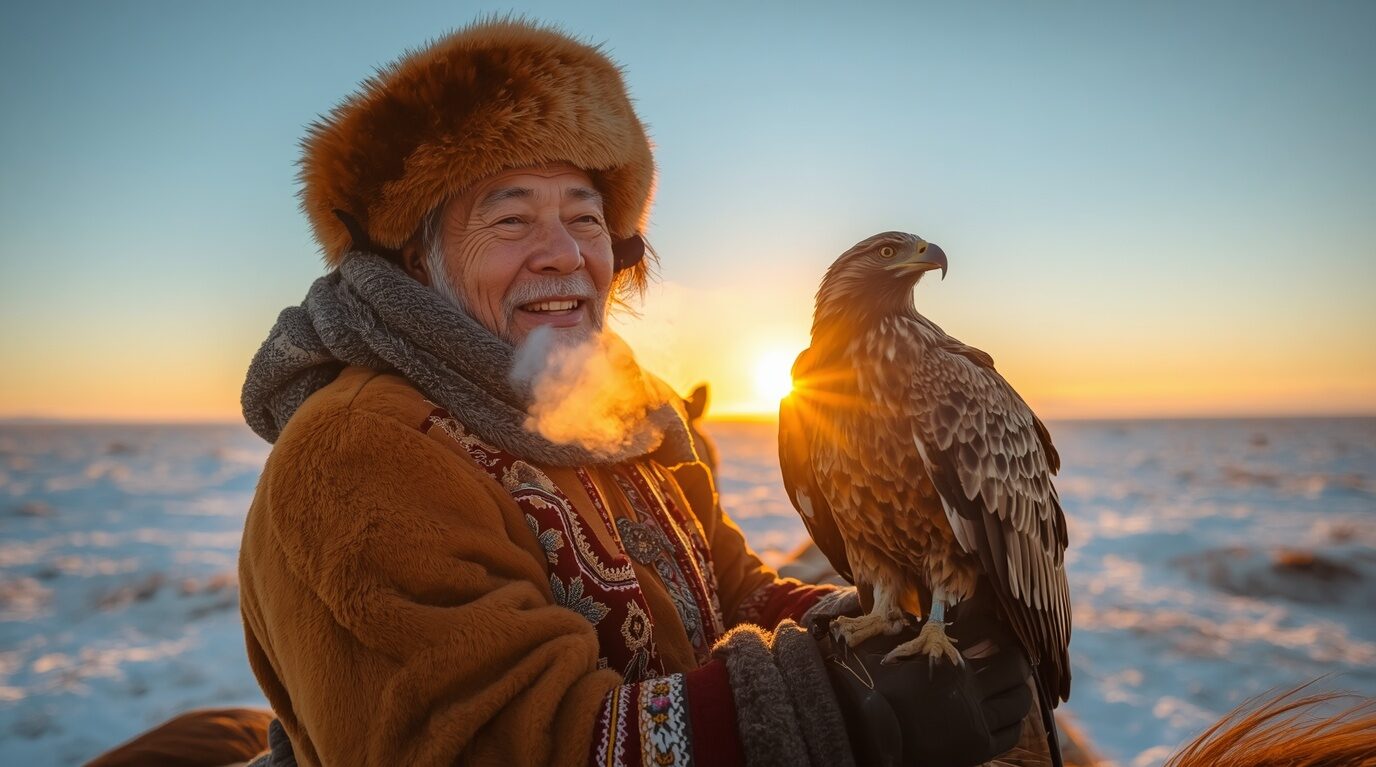
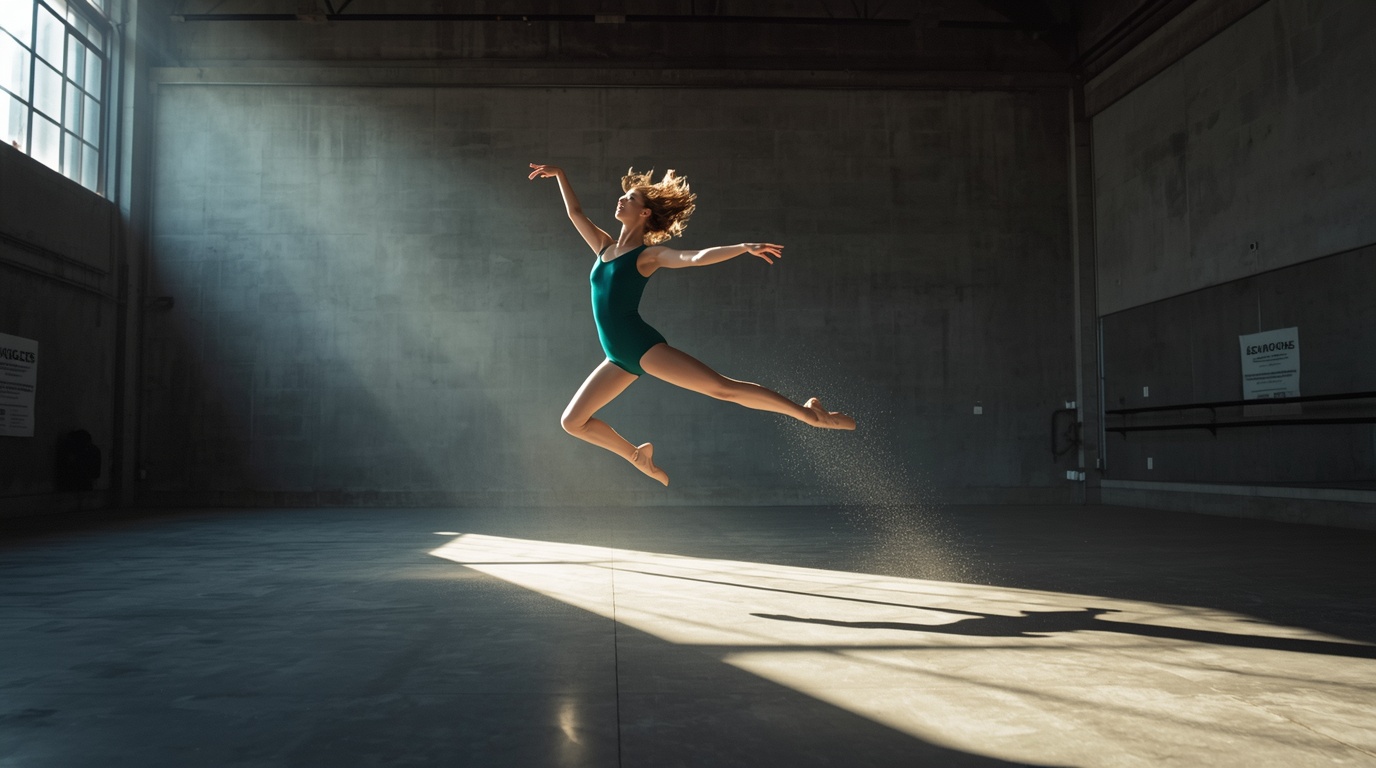
Кадры из видео Seedance
Доступ в России
Через посредника
Прямого входа на площадку ByteDance из России нет. Рабочий путь — российский сервис, который берёт оплату на себя и открывает доступ к модели вместе с остальными нейросетями в одном кабинете.
По API
Если модель встраивают в свой продукт, доступ берут через BytePlus — коммерческую площадку ByteDance. Это путь для разработчиков, а не для разовой генерации.
Частые вопросы
До 30 секунд в Seedance 2.5. Ролик можно продлить дважды, поэтому история собирается законченная.
Да, начиная с 2.5. Это модель совместной генерации звука и видео: аудио приходит в той же генерации, что и картинка, отдельным шагом озвучку добавлять не нужно.
Тремя вещами: длиной ролика с продлением, совместной генерацией звука и тем, как читается референс — в 2.5 модель считывает замысел, кадрирование и киноязык, а не просто переносит движение. Плюс появились управление по белой модели и правка на хромакее.
Только, если нужен короткий ролик без звука: перебивка, тест идеи, черновик композиции.
Способ задать сцену не картинкой, а геометрией: на вход идёт болванка без текстур, по ней модель понимает объём, расстановку и движение камеры, а материал и свет добавляет сама.
Прямого входа на площадку ByteDance нет. Работают два пути: доступ через российского посредника, который берёт оплату на себя, и подключение по API через BytePlus, если модель встраивают в свой продукт.